「猫の写真なら、耳が二つあって、ひげがあって……」と条件を書いても、横向きの猫、耳が隠れた猫、ぬいぐるみが混ざると、すぐに例外が増えます。そこで、多くの画像から見分けるためのパターンを学ぶ方法が登場します。
ディープラーニングは、複数の層を持つニューラルネットワークを使う機械学習の方法です。AIという広い分野の中に機械学習があり、その中にディープラーニングがあります。
「深い」は、層を重ねること
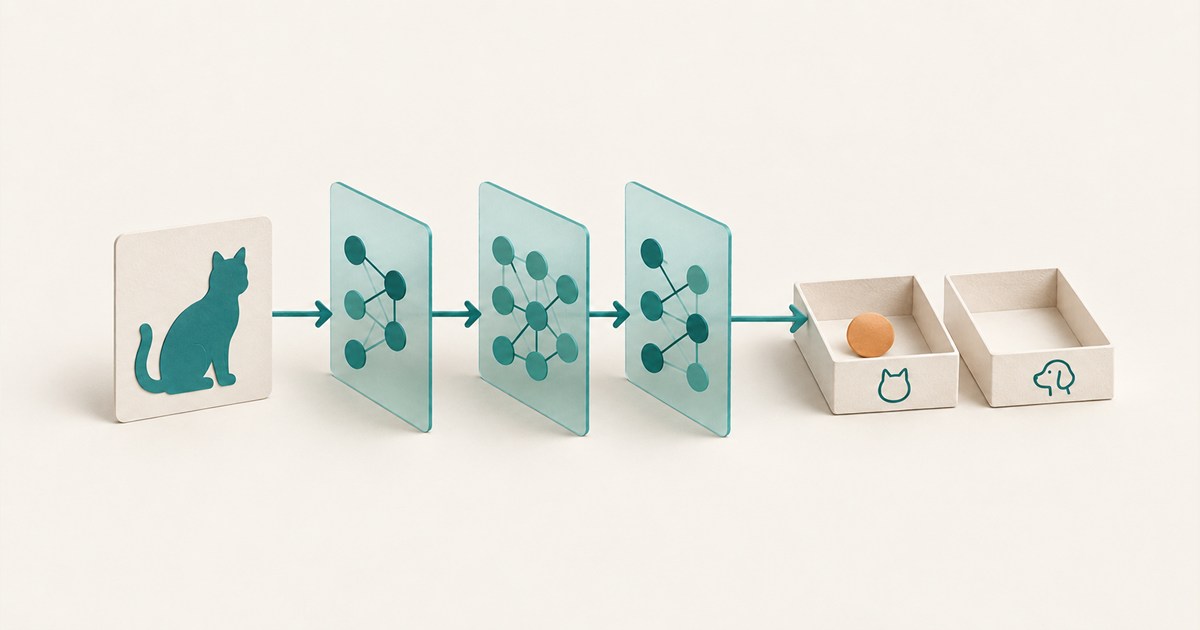
ニューラルネットワークは、入力を数値として受け取り、重みなどのパラメーターを使った計算を重ねて、出力へ変換します。名前は神経回路から来ていますが、人間の脳をそのまま再現したものではありません。
猫かどうかを分類する例なら、画像の数値を受け取り、いくつもの変換を経て、猫らしさを表す出力を作ります。中間の各層が何を表すかは、モデルや学習方法によって変わります。
学習では、間違いを使って調整する
ここでは、猫と猫以外のラベルが付いた画像で学ぶ、教師あり学習を考えます。
- 画像を入力し、モデルの予測を出す。
- ラベルとの違いを、損失という数値で表す。
- パラメーターを変えると損失がどう変わるかを計算する。
- 損失を小さくする方向へ、少しずつ調整する。
誤差逆伝播、つまりバックプロパゲーションは、パラメーターへの影響を効率よく計算する方法です。実際の更新には勾配降下法などを組み合わせます。IBMの解説で、この二つの役割が説明されています。
学習と推論の違い
学習はパラメーターを調整する工程、推論は学習したモデルを使って新しい入力への出力を計算する工程です。スマホでモデルを使うたびに、最初から大量の画像で学習し直す必要があるとは限りません。
写真の分類、音声認識、文章や画像の生成など、使い方は多様です。ディープラーニングは一つのアプリ名でも、一つの固定されたアルゴリズム名でもありません。
練習問題に強くても、初めての問題に強いとは限らない
学習に使った画像ばかりを正しく分類しても、新しい写真で外れることがあります。学習データに強く合わせすぎる過学習です。
例えば、架空のデータで、猫の写真がすべて室内、犬の写真がすべて屋外だったとします。モデルが動物より背景に頼っていたら、外にいる猫で間違えるかもしれません。
そこで、調整用の検証データや、最後の評価用のテストデータを分けます。同じ写真の少し違う切り抜きが両方に入れば、見かけ上の成績が高くなる可能性もあるので、分け方まで確かめます。
アプリで使うなら、全体の正解率だけを見ない
正解率が高くても、暗い写真だけで外れる、処理が遅い、端末で動かないという問題が残るかもしれません。使う場面を決めて、次のような確認を行えます。
- どんな入力で間違えるか。条件ごとの結果を見る。
- 待ち時間やメモリー使用量が、実機で許容できるか。
- 間違った出力を、利用者が直したり取り消したりできるか。
ディープラーニングを理解する入口は、「人間のように分かった」と考えるより、データから調整した計算が、どんな新しい入力でも役立つかを試すことです。
AIの未来をめぐる別の問いは、シンギュラリティの記事で扱います。